
Esplora come analizzare milioni di sequenze con metodi bioinformatici per una comprensione più profonda dei campioni metagenomici.
Indice
- Introduzione
- Il problema dei dati grezzi: perché milioni di sequenze non bastano
- Classificazione tassonomica: chi è presente nel campione
- Annotazione funzionale: cosa possono fare i microrganismi
- Applicazioni pratiche nella ricerca e nella clinica
- Conclusioni
- Domande Frequenti
- Fonti
- Crediti fotografici
- Segui Microbiologia Italia
Questo articolo esplora i metodi bioinformatici che permettono di interpretare milioni di sequenze generate dal sequenziamento metagenomico. È utile a ricercatori, studenti di microbiologia e professionisti della salute che vogliono comprendere come i dati grezzi diventino informazioni biologiche concrete su chi vive in un campione e cosa può fare.
Introduzione
Nell’era della metagenomica, ogni campione ambientale o clinico può generare milioni di sequenze di DNA. Queste stringhe di lettere A, T, C e G rappresentano il genoma collettivo di intere comunità microbiche. Capire cosa significano non è più un compito opzionale, ma una necessità scientifica.
La quantità di dati prodotta dai sequenziatori di nuova generazione supera di gran lunga la capacità di analisi manuale. Un singolo run può produrre miliardi di basi, equivalenti a migliaia di genomi batterici completi. Senza strumenti computazionali avanzati, queste informazioni rimarrebbero solo numeri senza senso.
L’interpretazione delle sequenze massive richiede pipeline bioinformatiche che combinano qualità dei dati, assemblaggio, classificazione tassonomica e annotazione funzionale. Solo così è possibile trasformare un elenco di frammenti in una mappa della biodiversità e del potenziale metabolico.
Questo approccio ha rivoluzionato la microbiologia. Ha permesso di scoprire specie mai coltivate, di identificare geni di resistenza agli antibiotici e di studiare interazioni complesse tra microrganismi e ospite. La sfida principale rimane dare un significato biologico a ciò che le macchine leggono.
Il problema dei dati grezzi: perché milioni di sequenze non bastano
Quando un sequenziatore produce milioni di sequenze, il risultato iniziale è un file di testo pieno di stringhe corte e di bassa qualità. Questi reads devono essere filtrati, rimossi gli adattatori e scartate le sequenze dell’ospite se si analizza un campione umano o animale.
Senza questo passaggio di controllo qualità, qualsiasi analisi successiva rischia di essere contaminata da artefatti. Gli strumenti come FastQC e Trimmomatic sono diventati standard per garantire che solo i dati affidabili proseguano nel flusso di lavoro.
Anche dopo la pulizia, i reads rimangono frammentati. Un genoma batterico di 4 milioni di basi viene spezzato in pezzi di 150-300 nucleotidi. Ricostruire il puzzle richiede algoritmi di assemblaggio capaci di gestire la complessità di comunità miste.
Assemblaggio e ricostruzione di genomi
L’assemblaggio metagenomico utilizza grafi di de Bruijn per unire i k-mer sovrapposti. Programmi come MEGAHIT e metaSPAdes generano contigs, cioè sequenze più lunghe che rappresentano porzioni di genomi.
Da questi contigs si ottengono i MAG, i genomi assemblati dal metagenoma. Un MAG di alta qualità può coprire oltre il 90% di un genoma batterico e permettere di attribuire funzioni metaboliche precise.
Il processo non è semplice. Specie strettamente correlate e regioni ripetute creano ambiguità. Algoritmi di binning, come MetaBAT2 e MaxBin, raggruppano i contigs sulla base della copertura e della composizione nucleotidica.
Classificazione tassonomica: chi è presente nel campione
Una delle prime domande a cui rispondere è: chi vive lì dentro? La classificazione tassonomica assegna ogni sequenza a un gruppo filogenetico.
Per le analisi mirate sul gene 16S rRNA si usano database come SILVA e Greengenes, insieme a tool come QIIME2 e DADA2. Questi metodi sono rapidi ma forniscono solo informazioni di presenza e abbondanza relativa.
Nella metagenomica shotgun si confrontano i reads contro interi genomi di riferimento. Strumenti come Kraken2 e MetaPhlAn raggiungono risoluzioni fino al livello di specie o ceppo. Questo permette di distinguere patogeni da commensali e di monitorare la dinamica di comunità complesse.
La materia oscura microbica
Nonostante i progressi, una percentuale significativa di sequenze non trova omologia nei database esistenti. Questa “materia oscura” rappresenta organismi ancora sconosciuti o geni con funzioni inedite.
Studi su microbiomi umani e ambientali mostrano che fino al 25% delle sequenze assemblate in alcuni habitat rimane non classificata. Cataloghi come GEM hanno recuperato decine di migliaia di nuovi genomi, ampliando drasticamente la nostra visione della biodiversità.
L’uso di tecniche di deep learning sta accelerando l’annotazione di queste sequenze orfane. Reti neurali addestrate su milioni di proteine predicono strutture e possibili funzioni anche in assenza di omologie tradizionali.
Annotazione funzionale: cosa possono fare i microrganismi
Sapere chi è presente non basta. Bisogna capire cosa possono fare. L’annotazione funzionale collega le sequenze a processi metabolici, vie di biosintesi e potenziali di virulenza o resistenza.
Database come KEGG, COG e eggNOG forniscono mappe di riferimento. Gli strumenti di annotazione confrontano le proteine predette con queste risorse e assegnano termini Gene Ontology o moduli metabolici.
Quando le omologie sono deboli, entrano in gioco i metodi basati su intelligenza artificiale. DeepFRI e ESMFold predicono funzioni a partire dalla struttura tridimensionale, aumentando la copertura delle annotazioni fino a quasi il 99% dei geni assemblati in alcuni studi.
Pipeline complete e infrastrutture necessarie
Gestire milioni di sequenze richiede risorse computazionali importanti. Cluster di calcolo, storage di terabyte e pipeline automatizzate sono ormai indispensabili.
Piattaforme come MGnify dell’EBI offrono analisi standardizzate e accesso a miliardi di proteine non ridondanti. MetaGraph permette di interrogare repository di petabase in pochi secondi, trasformando archivi pubblici in motori di ricerca per DNA.
I ricercatori devono scegliere accuratamente ogni passaggio: dal controllo qualità all’assemblaggio, dal binning all’annotazione. Errori in una fase si propagano e possono portare a conclusioni errate.
Applicazioni pratiche nella ricerca e nella clinica
L’interpretazione delle sequenze massive ha applicazioni concrete. Nel microbioma intestinale aiuta a correlare composizioni specifiche con malattie metaboliche, infiammatorie e neurologiche.
In ambito ambientale consente di studiare comunità coinvolte nella degradazione di inquinanti o nel ciclo dei nutrienti. In microbiologia clinica, il sequenziamento metagenomico di campioni sterili può identificare patogeni non coltivabili in tempi più rapidi rispetto ai metodi tradizionali.
Le scoperte di nuovi enzimi e cluster biosintetici aprono strade per la biotecnologia e la scoperta di antibiotici. Ogni nuovo genoma recuperato da un MAG rappresenta una potenziale fonte di molecole bioattive.
Sfide aperte e prospettive future
Nonostante i progressi, restano limiti importanti. La standardizzazione dei protocolli è ancora incompleta. Differenze nei metodi di estrazione del DNA, nelle piattaforme di sequenziamento e nelle pipeline bioinformatiche rendono difficili i confronti tra studi.
La qualità dei MAG varia e molti restano incompleti o contaminati. L’integrazione di dati multi-omici (metatrascrittomica, metabolomica) è necessaria per passare dal potenziale genomico alla funzione reale.
L’intelligenza artificiale continuerà a giocare un ruolo centrale. Modelli sempre più grandi saranno in grado di predire interazioni microbiche e di suggerire ipotesi biologiche testabili in laboratorio.
Conclusioni
Capire cosa significano milioni di sequenze è diventato uno dei compiti centrali della microbiologia moderna. Attraverso pipeline bioinformatiche sofisticate è possibile trasformare dati grezzi in mappe tassonomiche e funzionali dettagliate.
Il processo richiede competenze interdisciplinari che uniscono biologia molecolare, statistica e informatica. Solo così le sequenze smettono di essere semplici stringhe di lettere e diventano conoscenza biologica utilizzabile.
Le prospettive future sono promettenti. Con l’aumento della potenza di calcolo e il miglioramento degli algoritmi, l’analisi di dataset sempre più grandi diventerà più accessibile e precisa. La microbiologia continuerà a beneficiare di questa capacità di leggere e interpretare il linguaggio nascosto dei genomi microbici.
Domande Frequenti
Chi analizza di solito i milioni di sequenze provenienti da studi metagenomici?
I bioinformatici e i microbiologi computazionali sono i principali protagonisti. Lavorano a stretto contatto con i biologi sperimentali per validare i risultati. Consiglio: collaborare sempre con un esperto di bioinformatica fin dalla fase di disegno dello studio.
Cosa rappresentano realmente i milioni di sequenze generate da un sequenziamento shotgun?
Rappresentano frammenti casuali del DNA totale presente nel campione, inclusi batteri, archea, virus e DNA dell’ospite. Consiglio: rimuovere sempre le sequenze dell’ospite prima di procedere con le analisi tassonomiche.
Quando è preferibile usare l’approccio a milioni di sequenze rispetto al sequenziamento del solo 16S?
Quando si vuole ottenere informazioni funzionali oltre a quelle tassonomiche, oppure quando si studiano organismi privi di un gene 16S tipico. Consiglio: valutare attentamente il budget e la complessità del campione prima di scegliere lo shotgun.
Come si passa dai reads grezzi a un significato biologico concreto?
Attraverso una pipeline che include controllo qualità, assemblaggio, binning, classificazione tassonomica e annotazione funzionale. Consiglio: documentare ogni parametro usato nei software per garantire riproducibilità.
Dove vengono depositati e resi pubblici i grandi dataset di sequenze?
Nei repository internazionali come ENA, SRA e nelle piattaforme specializzate come MGnify. Consiglio: depositare sempre i dati grezzi e i metadata completi per favorire la riusabilità.
Perché è importante interpretare correttamente i milioni di sequenze invece di fermarsi alla sola lista di specie?
Perché solo l’annotazione funzionale rivela il potenziale metabolico, i geni di resistenza e le interazioni ecologiche. Consiglio: integrare sempre i dati genomici con esperimenti di validazione funzionale quando possibile.
Fonti
- https://pubmed.ncbi.nlm.nih.gov/29959318/
- https://pubmed.ncbi.nlm.nih.gov/36477304/
- https://www.nature.com/articles/s41576-024-00746-6
- https://www.microbiologiaitalia.it/salute/un-miliardo-di-sequenze-dna-e-una-domanda/
- https://www.microbiologiaitalia.it/salute/cosa-puo-scoprire-un-computer-analizzando-milioni-di-sequenze-microbiche/
Crediti fotografici
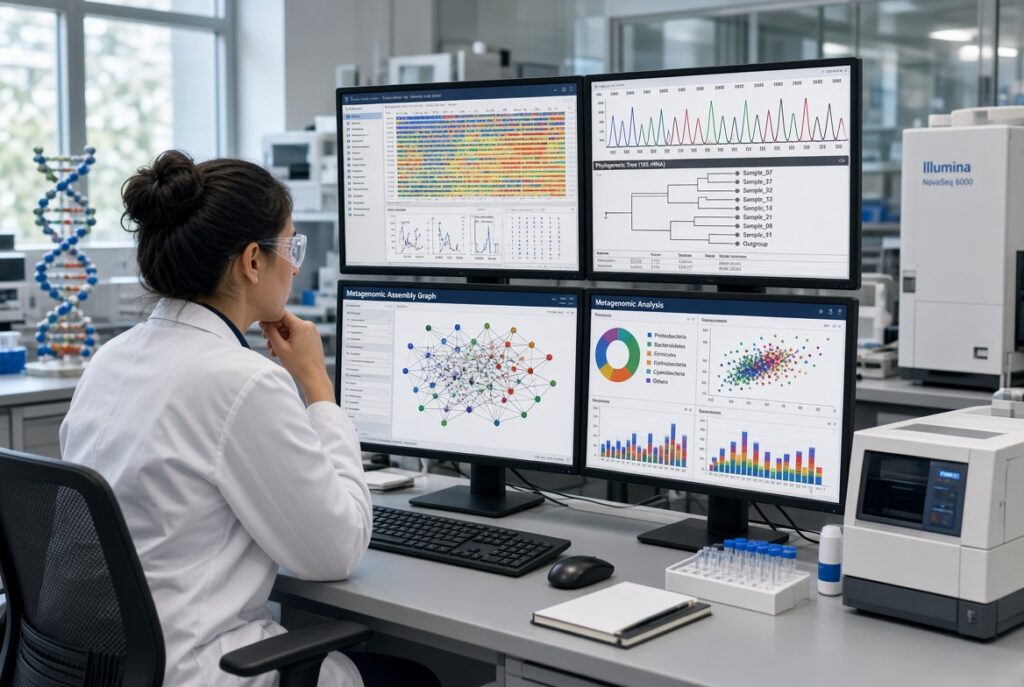
Immagine in evidenza generata con AI – Link
Segui Microbiologia Italia
Se ti è piaciuto questo contenuto e vuoi supportare Microbiologia Italia seguici su MSN e su Google News. Inserisci Microbiologia Italia tra le tue fonti preferite per ricevere aggiornamenti di qualità su argomenti scientifici simili.