
Scopri quando il DNA diventa codice e il significato delle sequenze di nucleotidi nella biologia molecolare.
Indice
- Introduzione
- Il DNA come deposito di informazione
- La decifrazione storica del codice genetico
- Caratteristiche fondamentali del codice
- Dalla trascrizione alla traduzione
- Eccezioni e varianti del codice
- Implicazioni in microbiologia e medicina
- Conclusioni
- Domande Frequenti
- Fonti
- Crediti fotografici
- Segui Microbiologia Italia
Questo articolo esplora il momento in cui il DNA diventa codice, analizzando il codice genetico, la sua decifrazione storica, le caratteristiche molecolari e le implicazioni biologiche moderne. Risulta utile a studenti di microbiologia, ricercatori, appassionati di biologia molecolare e professionisti sanitari che desiderano comprendere come l’informazione nucleica si traduca in funzione proteica, offrendo una visione chiara e aggiornata del linguaggio universale della vita.
Introduzione
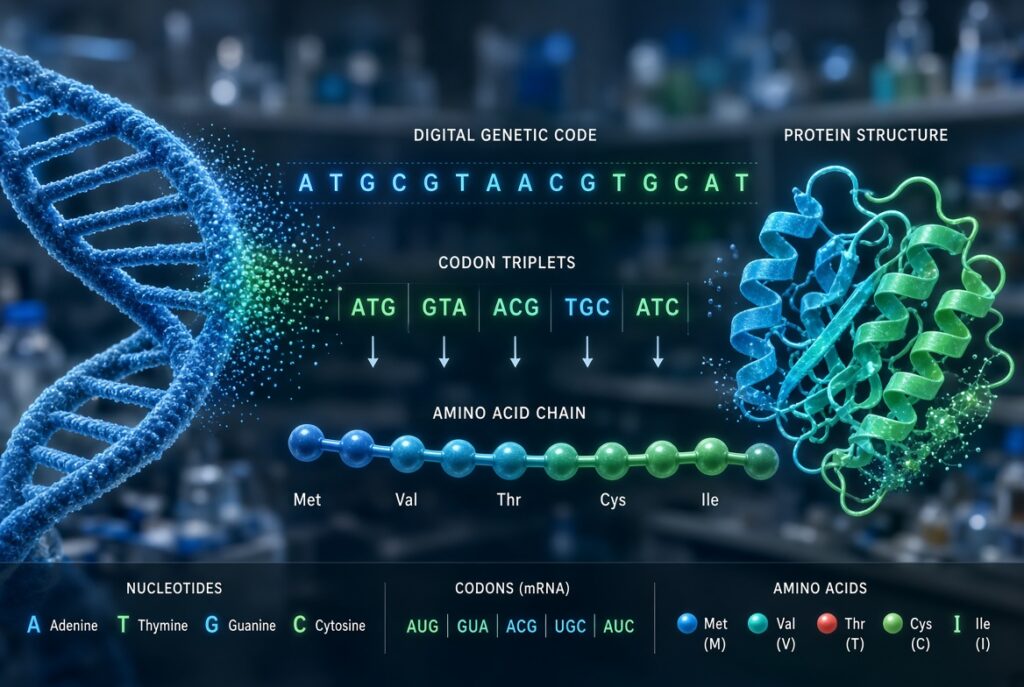
Il passaggio da semplice molecola a sistema informativo rappresenta uno dei salti più straordinari della biologia. Quando il DNA diventa codice, le quattro basi azotate smettono di essere sole lettere chimiche e acquisiscono significato. Ogni sequenza di tre nucleotidi, chiamata codone, corrisponde a un amminoacido specifico o a un segnale di interruzione. Questo linguaggio, quasi universale, permette a batteri, piante e mammiferi di costruire le stesse proteine a partire dalle medesime istruzioni. Comprendere questo processo significa capire come l’informazione genetica si traduce in struttura e funzione cellulare, un tema centrale per chi studia microbiologia e biologia molecolare.
Il DNA come deposito di informazione
Prima che il DNA diventi codice, esso esiste come doppia elica stabilizzata da legami a idrogeno. Le basi adenina, timina, citosina e guanina formano le “lettere” del futuro messaggio. La struttura a doppia elica, scoperta da Watson e Crick, suggerì immediatamente la possibilità di una copia fedele dell’informazione. Tuttavia, il solo DNA non produce proteine: deve essere trascritto in RNA messaggero. Solo a quel punto la sequenza nucleotidica acquisisce valore operativo e il DNA diventa codice leggibile dai ribosomi.
Dalla sequenza alla tripletta
La natura tripletta del codice non fu immediata. Con quattro basi disponibili, una combinazione di due generava soltanto 16 possibilità, insufficienti per i 20 amminoacidi. Solo tre basi permettevano 64 combinazioni, numero più che adeguato. Questa evidenza matematica spinse i ricercatori a concentrarsi sulle triplette. Ogni gruppo di tre nucleotidi sull’mRNA prende il nome di codone e determina quale amminoacido verrà aggiunto alla catena polipeptidica in formazione.
La decifrazione storica del codice genetico
Il momento preciso in cui il DNA diventa codice riconosciuto dalla scienza risale agli anni Sessanta. Marshall Nirenberg e Heinrich Matthaei dimostrarono nel 1961 che un RNA sintetico composto solo da uracile produceva polifenilalanina. Quel singolo risultato aprì la strada alla completa mappatura. Successivamente, utilizzando RNA con sequenze note, gli scienziati assegnarono ogni codone al rispettivo amminoacido. In pochi anni l’intero dizionario fu completato, rivelando che il DNA diventa codice attraverso regole precise e quasi invariabili.
I protagonisti della scoperta
Nirenberg, Matthaei, Crick, Brenner e molti altri contribuirono a trasformare un’ipotesi in conoscenza consolidata. Gli esperimenti in vitro con sistemi acellulari permisero di isolare il meccanismo di traduzione senza interferenze cellulari. Il risultato fu la tabella del codice genetico ancora oggi utilizzata: 61 codoni senso e tre codoni di stop. Questa conquista rappresentò uno dei maggiori successi della biologia molecolare del Novecento e dimostrò che il DNA diventa codice in modo quasi identico in tutti gli organismi viventi.
Caratteristiche fondamentali del codice
Il codice genetico presenta proprietà che ne garantiscono efficienza e robustezza. È degenerato: più codoni possono codificare lo stesso amminoacido. È non ambiguo: ogni codone specifica un solo amminoacido. È continuo: non esistono “virgole” o spazi tra un codone e l’altro. È quasi universale: le stesse triplette valgono dalla Escherichia coli all’essere umano, con poche eccezioni mitocondriali e in alcuni protisti. Queste caratteristiche spiegano perché il DNA diventa codice in maniera affidabile attraverso miliardi di anni di evoluzione.
Degenerazione e robustezza
La degenerazione protegge da molte mutazioni puntiformi. Spesso una sostituzione nella terza posizione del codone non cambia l’amminoacido prodotto. Questo fenomeno, noto come wobble, riduce l’impatto di errori di replicazione o di trascrizione. Allo stesso tempo, i codoni di start (AUG) e di stop (UAA, UAG, UGA) definiscono i confini del messaggio. Quando il DNA diventa codice, questi segnali assicurano che la proteina inizi e termini nel punto corretto.
Continuity e reading frame
Il frame di lettura è cruciale. L’inserzione o la delezione di una sola base sposta l’intero schema di lettura, generando una proteina completamente diversa e spesso non funzionale. Questo tipo di mutazione, detta frameshift, evidenzia quanto sia delicato il momento in cui il DNA diventa codice. La cellula ha sviluppato meccanismi di controllo, come il nonsense-mediated decay, per eliminare messaggeri difettosi e limitare i danni.
Dalla trascrizione alla traduzione
Il percorso che trasforma il DNA in proteina passa attraverso due fasi principali. Nella trascrizione, l’RNA polimerasi copia il gene in un filamento di mRNA. Nella traduzione, i ribosomi leggono l’mRNA tre basi alla volta e assemblano la catena di amminoacidi. Solo in questa fase il DNA diventa codice operativo. I tRNA fungono da adattatori: ciascun tRNA porta un amminoacido specifico e riconosce il codone complementare tramite il proprio anticodone.
Il ruolo dei ribosomi
I ribosomi sono macchine molecolari altamente sofisticate. Nei procarioti sono 70S, negli eucarioti 80S, ma il principio di funzionamento resta analogo. Il sito A accoglie il tRNA carico, il sito P ospita la catena nascente e il sito E rilascia il tRNA scarico. Ogni ciclo di elongazione aggiunge un amminoacido e sposta l’mRNA di tre nucleotidi. In questo modo continuo e processivo, il DNA diventa codice tradotto in struttura proteica tridimensionale.
Regolazione e controllo di qualità
Non tutto il DNA codifica proteine. Grandi porzioni di genoma eucariotico sono non codificanti o regolatorie. Anche quando una sequenza è trascritta, l’mRNA può essere modificato, degradato o trattenuto nel nucleo. La cellula decide quindi se e quando il DNA diventa codice effettivamente espresso. Meccanismi epigenetici, microRNA e fattori di trascrizione modulano questo processo con grande precisione.
Eccezioni e varianti del codice
Sebbene quasi universale, il codice non è del tutto immobile. Nei mitocondri di molti organismi, alcuni codoni hanno significato diverso. In certi protisti e batteri si osservano riassegnazioni naturali. Più di recente, la biologia sintetica ha creato codici artificiali che incorporano amminoacidi non standard. Queste varianti dimostrano che il DNA diventa codice in modo evolutivo e, potenzialmente, progettato dall’uomo.
Il concetto di incidente congelato
Francis Crick propose che l’assegnazione originaria dei codoni agli amminoacidi fosse in gran parte casuale e poi “congelata” perché qualsiasi cambiamento successivo sarebbe stato letale. Studi più recenti mostrano che il codice continua a evolversi in nicchie particolari, pur restando fortemente conservato. Comprendere queste eccezioni aiuta a capire i limiti e le possibilità del momento in cui il DNA diventa codice.
Applicazioni in biologia sintetica
Oggi i ricercatori riscrivono parti del codice per inserire amminoacidi non naturali, creare organismi resistenti ai virus o sviluppare sistemi di biocontenimento. Queste manipolazioni partono dalla conoscenza precisa di come il DNA diventa codice e di quali codoni possono essere liberati o riassegnati senza compromettere la vitalità cellulare.
Implicazioni in microbiologia e medicina
In microbiologia, conoscere il codice permette di interpretare genomi batterici, prevedere proteine virali e progettare vaccini a mRNA. In medicina, le mutazioni che alterano codoni di stop o di senso sono alla base di numerose patologie genetiche. Terapie geniche e editing CRISPR intervengono proprio sul punto in cui il DNA diventa codice, correggendo sequenze errate o introducendo istruzioni terapeutiche.
Diagnostica e ricerca
Tecniche come il sequenziamento di nuova generazione leggono milioni di codoni al giorno. L’analisi bioinformatica traduce queste sequenze in proteine predette e in funzioni potenziali. Per i microbiologi, questo significa identificare patogeni emergenti, resistenze antibiotiche e potenziali target terapeutici con rapidità mai vista prima. Ogni sequenza letta è un’ulteriore conferma di come il DNA diventa codice interpretabile.
Prospettive future
La possibilità di espandere il codice genetico apre scenari di proteine con proprietà nuove, materiali biologici avanzati e organismi progettati per compiti specifici. Allo stesso tempo, solleva questioni etiche e di biosicurezza. La comprensione approfondita del processo resta la base su cui costruire queste innovazioni in modo responsabile.
Conclusioni
Quando il DNA diventa codice, la vita acquisisce un linguaggio comune capace di costruire complessità a partire da quattro semplici lettere. Dalla doppia elica alla proteina funzionale, il percorso è regolato, robusto e quasi universale. La decifrazione di questo codice ha rappresentato una delle più grandi conquiste scientifiche del secolo scorso e continua a guidare scoperte in microbiologia, genetica e biotecnologia. Studiare il momento in cui il DNA diventa codice significa comprendere le regole fondamentali della biologia e le potenzialità infinite che da esse derivano. Continuare a esplorare le eccezioni e le applicazioni sintetiche arricchirà ulteriormente questa conoscenza, offrendo strumenti sempre più precisi per la ricerca e la salute umana.
Domande Frequenti
Chi ha decifrato per primo il codice genetico?
Marshall Nirenberg e Heinrich Matthaei, con l’esperimento del 1961 basato su poli-U, aprirono la strada alla completa mappatura.
Consiglio: approfondisci sempre le pubblicazioni originali per cogliere il contesto sperimentale.
Cosa significa esattamente che il DNA diventa codice?
Significa che le sequenze di tre nucleotidi vengono interpretate come istruzioni per inserire amminoacidi specifici durante la sintesi proteica.
Consiglio: visualizza la tabella dei codoni per memorizzare le corrispondenze principali.
Quando avviene la traduzione del codice genetico?
La traduzione avviene nei ribosomi dopo che l’mRNA è stato trascritto e processato, sia nei procarioti sia negli eucarioti.
Consiglio: ricorda che la fase di inizio, elongazione e terminazione sono distinte e regolate.
Come viene letto il codice genetico?
Viene letto a triplette consecutive senza interruzioni, a partire dal codone di start fino a un codone di stop.
Consiglio: presta attenzione al reading frame per evitare errori di interpretazione nelle sequenze.
Dove si trova il codice genetico all’interno della cellula?
Il codice è contenuto nel DNA nucleare o nucleoidale e viene espresso attraverso l’mRNA nei ribosomi citoplasmatici o legati al reticolo.
Consiglio: distingue sempre tra localizzazione dell’informazione e sito di traduzione.
Perché il codice genetico è quasi universale?
Perché deriva da un antenato comune e qualsiasi modifica radicale sarebbe stata incompatibile con la sopravvivenza della maggior parte degli organismi.
Consiglio: studia le poche eccezioni note per capire i limiti della conservazione evolutiva.
Fonti
- https://pubmed.ncbi.nlm.nih.gov/41253125/
- https://www.sciencedirect.com/science/article/abs/pii/S0960982225013028
- https://pubmed.ncbi.nlm.nih.gov/39088192/
- https://www.microbiologiaitalia.it/didattica/codice-genetico/
- https://www.microbiologiaitalia.it/guru-della-microbiologia/marshall-nirenberg-il-primo-ricercatore-a-decifrare-il-codice-genetico/
Crediti fotografici
Immagine in evidenza generata con AI – Link
Segui Microbiologia Italia
Se ti è piaciuto questo contenuto e vuoi supportare Microbiologia Italia seguici sue su Google News. Inserisci Microbiologia Italia tra le tue fonti preferite per ricevere aggiornamenti di qualità su argomenti scientifici simili.